
Деконструкція правила 10/20-70 у сучасних контент-операціях
Сучасні контент-операції стикаються зі структурною кризою: як масштабувати обсяги випуску матеріалів без зниження тонкої якості, якої вимагають пошукові системи та читачі-люди. Щоб впоратися з цією напругою, цифрові видавці та маркетингові команди почали впроваджувати структуровані фреймворки для балансування машинної ефективності та людського нагляду. Однією з таких операційних моделей, що завойовує популярність серед прогресивних редакційних команд, є правило 10/20-70. Спочатку розроблене у посібниках з оптимізації робочих процесів платформами цифрової стратегії, такими як Launchmind у 2026 році, цей фреймворк найкраще сприймати як практичний редакційний план, а не як офіційно стандартизований галузевий бенчмарк чи жорсткий мандат, продиктований алгоритмами пошукових систем. Творці контенту повинні уникати розгляду співвідношення 10/20-70 як універсально вимірюваного показника або гарантованого скороченого шляху до топ-позицій у рейтингах; швидше, воно слугує корисною евристикою для розподілу праці в межах гібридного виробничого конвеєра.
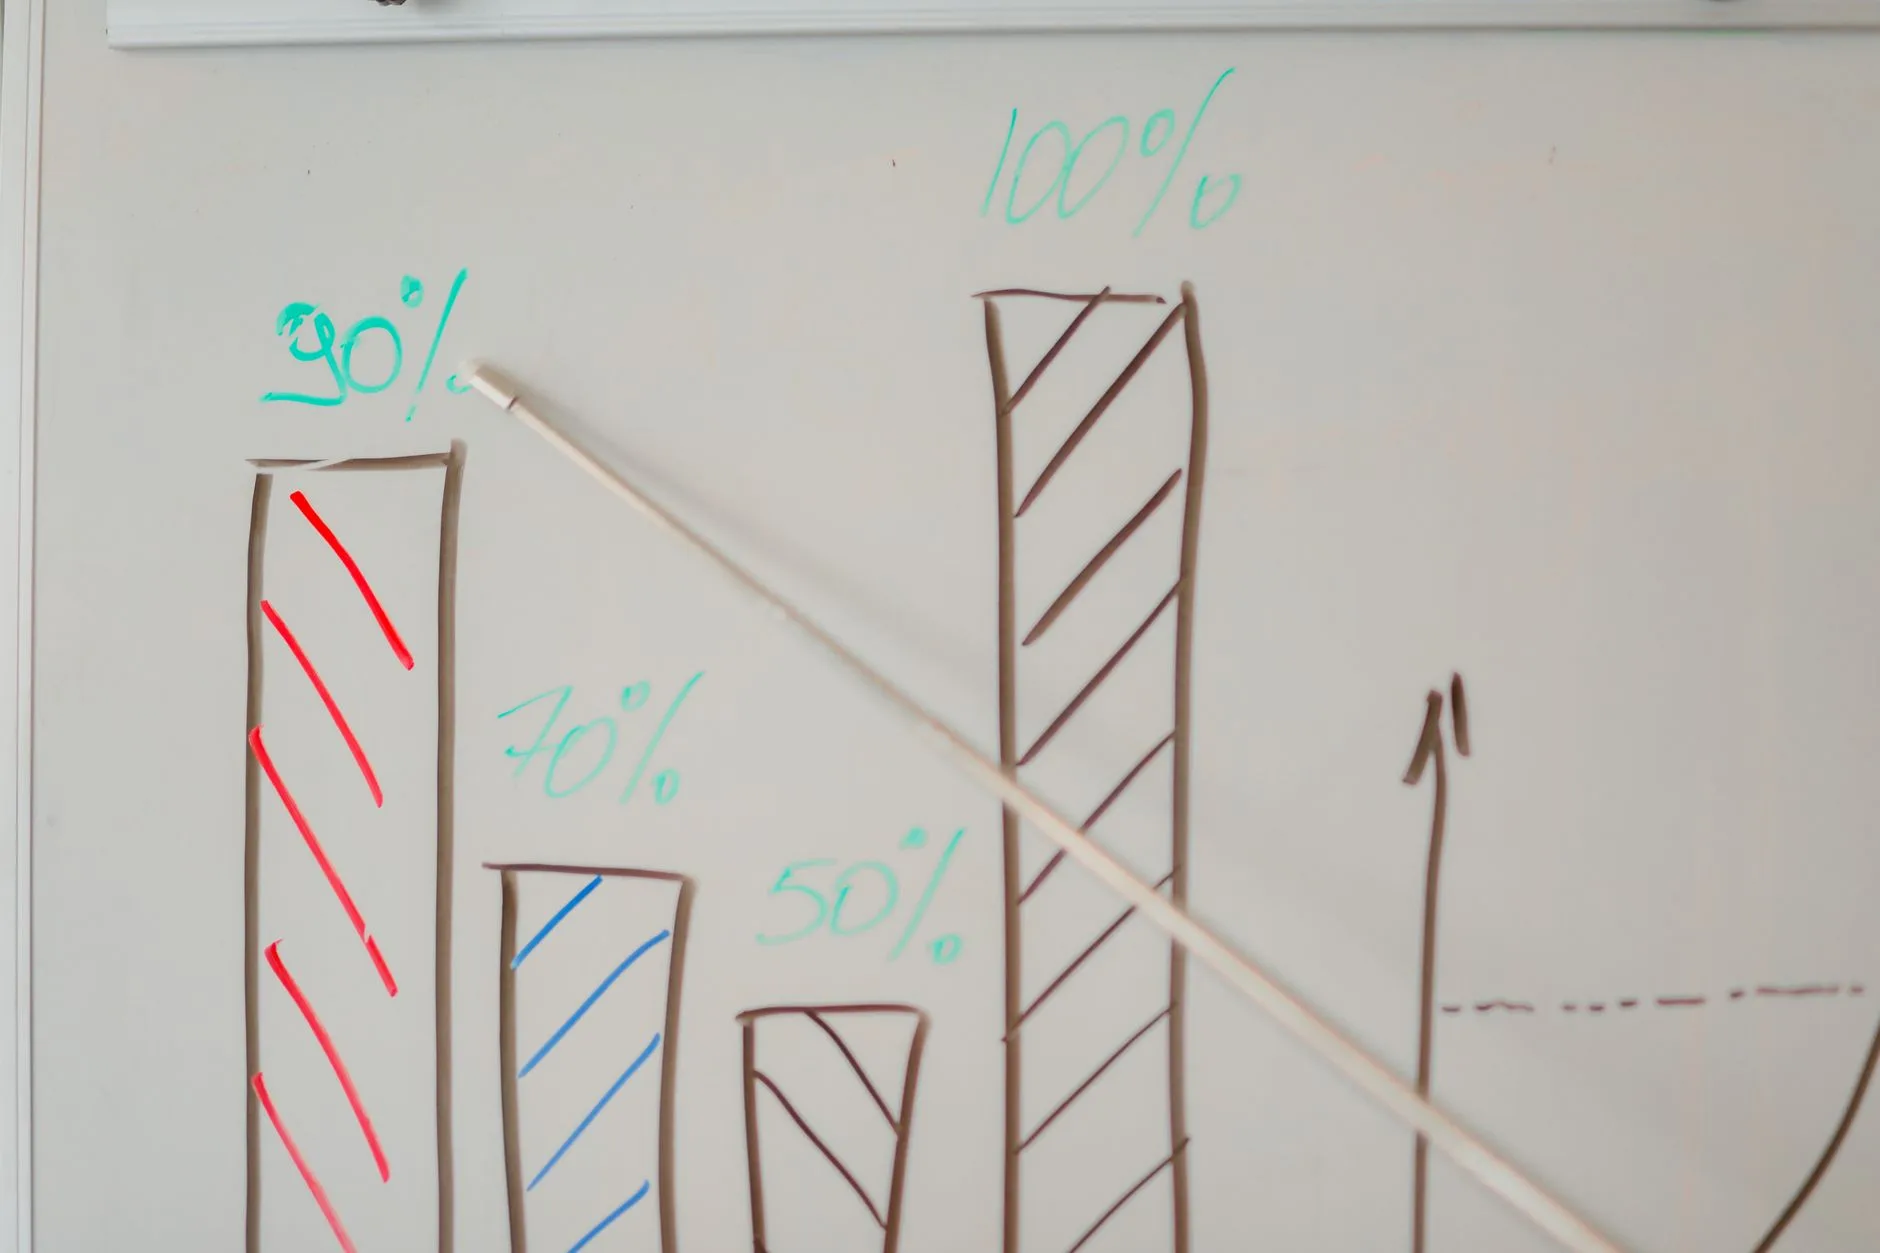
Щоб повністю зрозуміти, як цей фреймворк працює у повсякденній видавничій діяльності, необхідно розглянути, як робоче навантаження поділяється математично та операційно. Фреймворк пропонує виділяти приблизно 10 відсотків загальних зусиль на виробництво для підтримки планування, 20 відсотків — на створення первинного чорновика за допомогою штучного інтелекту, а решту 70 відсотків залишати міцно в руках людей. Цей розподіл одразу спростовує поширену помилкову думку про те, що штучний інтелект може повністю замінити людей-авторів. Натомість технологію відведено до попередніх, механічних фаз життєвого циклу контенту, тоді як людські експерти зберігають абсолютний контроль над інтелектуальною глибиною, стратегічним спрямуванням та фінальним втіленням кожної опублікованої статті.
Початкові 10 відсотків робочого процесу присвячені повністю підтримці планування та базовим дослідженням. Під час цієї фази менеджери контенту можуть використовувати великі мовні моделі та аналітичні інструменти для брейнштормінгу тематичних кластерів, створення первинних списків розширення ключових слів, окреслення структурних схем та опрацювання поширених запитань. Проте ця фаза вимагає пильного нагляду людини, щоб гарантувати, що згенеровані плани відповідають ширшим цілям бренду та намірам аудиторії. Використовуючи штучний інтелект виключно як інструмент для обговорення під час фази генерування ідей, команди можуть швидко подолати синдром чистого аркуша, не застрягаючи на помилковому структурному шляху.
Рухаючись далі по конвеєру, наступні 20 відсотків робочого процесу виділяються на виробництво первинного чорновика за допомогою штучного інтелекту. Щойно редактори-люди встановлюють надійний план і чіткі стратегічні параметри, можна розгортати генеративні моделі для написання сирого тексту розповіді, деталізації базових визначень та створення стандартних вступних чи перехідних абзаців. Саме тут штучний інтелект забезпечує свою найвищу механічну цінність, різко скорочуючи час, необхідний для перетворення плану на читабельний блок тексту. Проте видавці повинні чітко усвідомлювати обмеження, притаманні сирому машинному виведенню, яке часто включає поверхневий аналіз, повторювані формулювання та загальні переходи.
Це підводить нас до найважливішого компонента всієї операції: решти 70 відсотків, які запекло обстоюють редактори-люди, експерти з певної тематики та фахівці з перевірки фактів. Ці значні інвестиції людського капіталу є саме тим, що відрізняє авторитетний, високоякісний контент від величезного моря автоматизованого спаму, який зараз наповнює цифровий екосукупність. В епоху, коли пошукові системи постійно оновлюють свої метрики оцінювання, щоб винагороджувати справжню експертність та практичний досвід — як це помітно в інсайтах прогнозування алгоритмів, висвітлених у Search Engine Journal — керовані людиною 70 відсотків є невіддільною частиною процесу.
Під час цієї масштабної фази, де домінують люди, редактори повинні використати низку суворих втручань, які виходять далеко за межі базового вичитування тексту. Ці обов’язки включають:
- Глибока перевірка фактів: Перевірка кожного твердження, статистики та історичного посилання, створеного машиною, щоб гарантити, що в кінцевий текст не просочаться галюцинації чи застаріла інформація.
- Інтеграція оригінального розуміння: Вплетення власних даних, унікальних кейсів, експертних інтерв’ю та перспектив із перших рук, які штучний інтелект ніколи б не зміг згенерувати самостійно.
- Тон і відповідність бренду: Переписування уривків відповідно до унікального голосу, стилістичних нюансів та емпатичного резонансу видання.
- Структурне вдосконалення: Реструктуризація аргументів для покращення логічного потоку, залученості читачів та шляхів конверсії.
Зрештою, правило 10/20-70 діє одночасно як захисна та наступальна стратегія. Воно захищає редакційну цілісність, гарантуючи, що людська експертність залишається беззаперечним якірним елементом кожного рішення про публікацію, одночасно захищаючи команди від штрафів за якість, пов’язаних із невідредагованим, повністю автоматизованим масштабуванням контенту. Знаходження правильної рівноваги вимагає постійного калібрування, як це детальніше досліджується в обговореннях щодо AI Content vs. Humans: Finding the 2026 Balance. Розглядаючи цей фреймворк як гнучкий орієнтир, а не як незмінний закон, сучасні контент-операції можуть успішно використовувати швидкість автоматизації, водночас захищаючи незамінну глибину людського інтелекту.
Використання чорнових матеріалів ШІ як відправної точки в робочому процесі редагування контенту зі ШІ
У сучасній екосистемі цифрових видань спокуса ставитися до великих мовних моделей як до автономних видавничих двигунів залишається дорогою пасткою для маркетингових команд, які масштабують свою діяльність. Як зазначено в аналізі робочих процесів Launchmind (2026), сприйняття згенерованого штучним інтелектом чорновика як остаточного матеріалу, готового до публікації, докорінно хибно розуміє технологічні межі машинної інтелектності та підриває цілісність контент-маркетингу. Натомість успішні редакційні команди впроваджують індустріалізований робочий процес редагування контенту зі ШІ, де необроблений текст машини функціонує виключно як базова відправна точка — структурований, надзвичайно податливий макет, призначений для інтенсивного доопрацювання людиною, а не для негайного споживання громадськістю.
Коли великі мовні моделі генерують текст, вони працюють на основі імовірнісних патернів, отриманих із величезних навчальних масивів даних, синтезуючи синтаксис та історичну інформацію, а не володіючи справжнім когнітивним розумінням чи життєвим досвідом. Ця алгоритмічна основа створює системні вразливості, зокрема поверхневі узагальнення, неперевірені галюцинації даних та загальний, гомогенізований тон, який не резонує з витонченою аудиторією. Отже, людський редактор повинен втрутитися, щоб подолати прірву між автоматизованим синтезом тексту та високопродуктивними, авторитетними цифровими активами. Цей процес трансформації вимагає систематичного підходу до деконструкції та відбудови початкового чорновика, гарантуючи, що кожен шматок опублікованого матеріалу задовольняє чіткі потреби аудиторії та підтримує суворі редакційні стандарти.
Першим критичним втручанням у цей робочий процес після генерації є впровадження оригінального розуміння та пропрієтарної експертизи. Автоматизовані інструменти часто переробляють загальноприйняту мудрість і точки зору консенсусу, яких вдосталь у відкритому вебпросторі, що призводить до створення контенту, якому бракує справжньої перспективи чи нової цінності. Експерти з предметної галузі повинні впроваджувати пропрієтарні дані, практичні тематичні дослідження, стратегічні фреймворки та контрінтуїтивні галузеві точки зору, які LLM аж ніяк не могла екстраполювати з публічних навчальних даних. Вбудовуючи ці шари оригінальної думки, редактори піднімають матеріал із загального товару до авторитетного ресурсу, який здатний щиро привернути увагу користувачів та забезпечити органічну видимість у конкурентних пошукових ландшафтах.
Водночас редакційний етап вимагає суворої перевірки фактів та тверджень. Оскільки моделі прогнозують послідовності слів на основі статистичної ймовірності, а не фактичної точності, вони часто вигадують правдоподібно звучалу статистику, неправильно приписують історичні події або посилаються на неіснуючі дослідження. Досвідчений людський редактор повинен самостійно перевіряти кожне фактичне твердження, перехресно перевіряти точки даних з першоджерелами та замінювати порожні узагальнення точними, перевіреними доказами. Цей крок є особливо життєво важливим для брендів, які працюють у конкурентних або суворо регульованих галузях, де публікація неперевірених галюцинацій ШІ може серйозно зашкодити інституційній довірі, підірвати довіру споживачів та порушити правила пошукових систем щодо якості та корисності контенту.
Окрім фактичної валідації, робочий процес вимагає ретельного узгодження з унікальним голосом бренду та стилістичною ідентичністю організації. Неодредаговані результати роботи ШІ тяжіють до прісного, надмірно ввічливого та повторюваного реєстру, що характеризується передбачуваними перехідними фразами та відсутністю справжньої риторичної індивідуальності. Щоб запобігти розмиванню бренду, редактори повинні активніше змінювати синтаксис, кадренс та словниковий запас, щоб відображати конкретні рекомендації щодо тону видавничої структури. Для організацій, які прагнуть ефективно масштабувати цей процес без шкоди для стилістичної послідовності, вивчення передових операційних фреймворків, подібних до тих, що детально описані в нашому керівництві про те, як LLM живлять сучасне створення контенту зі ШІ [L6], надає цінний контекст щодо подолання розриву між машинною генерацією та людським вираженням.
Щоб ефективно втілити ці принципи в життя, контент-команди часто покладаються на струкхований розподіл праці між автоматизованою генерацією та наглядом з боку людини. Наступний фреймворк окреслює основні обов’язки на кожному етапі зрілого видавничого конвеєра:
| Етап робочого процесу | Основна відповідальність | Ключовий операційний фокус |
|---|---|---|
| Фаза генерації | Модель ШІ / Інструмент контенту | Створення структурних планів, базових абзаців та швидке написання повторюваних розділів. |
| Фаза перевірки | Людський редактор / Дослідник | Перевірка фактів, аудит точок даних та видалення галюцинаторних посилань. |
| Фаза покращення | Експерт з предметної галузі | Впровадження пропрієтарного розуміння, реальних прикладів та унікальних галузевих перспектив. |
| Фаза полірування | Головний редактор / Копірайтер | Узгодження тону та словникового запасу з правилами бренду, оптимізація потоку та забезпечення повного задоволення намірів користувача. |
Зрештою, зрілий робочий процес редагування контенту зі ШІ визнає, що технологія існує для прискорення продуктивності, а не для заміни критичного людського мислення. Коли команди ставляться до сирих результатів моделей лише як до структурного риштування, вони розблоковують швидкість автоматизації, водночас захищаючи нюанси, авторитет та емоційний резонанс, яких вимагає аудиторія. Для організацій, які прагнуть підтримувати цей тонкий баланс, розширюючи свій обсяг виробництва, вивчення стратегічних методологій, подібних до тих, що містяться в нашому вичерпному посібнику про те, як автоматизувати створення контенту без втрати голосу бренду [L1], пропонує практичні ідеї для підтримки довгострокової редакційної досконалості.
Впровадження суворих контрольних точок контенту за участю людини (Human-in-the-Loop)
Оскільки організації масштабують свій цифровий вихід за допомогою автоматизованих робочих процесів і складних мовних моделей, інтеграція суворих механізмів нагляду стає життєво необхідною. У межах ширшої концепції балансування між створенням за допомогою машин та експертизою людини, контент із людиною в контурі (human-in-the-loop) означає, що людина є обов’язковим учасником на визначеній контрольній точці — схвалюючи, виправляючи або відхиляючи результати до того, як робочий процес просунеться далі, а не просто кимось, хто може перевірити їх пізніше, як визначено в парадигмах корпоративної архітектури компанією Sanity в їхній документації за 2026 рік щодо Human-in-the-loop (HITL). Надто багато видавничих команд роблять фатальну помилку, ставлячись до перевірки людиною як до асинхронного, необов’язкового аудиту, який відбувається після публікації. Справжнє управління робочим процесом вимагає жорстких зупинок у контент-пайплайні, де автоматизовані системи фізично блокуються від подальшого просування, поки кваліфікований експерт у відповідній галузі не підпише матеріали.
Створення цих обов’язкових операційних шлюзів є життєво важливим для підтримання безпеки бренду, фактичної точності та відповідності вимогам пошукових систем. Під час впровадження масштаובваної роботи з контентом — незалежно від того, чи керуєте ви скромним блогом, чи використовуєте складні системи, подібні до тих, що обговорюються в Best Content Automation Tools to Scale Operations in 2026 — ризик алгоритмічного дрейфу або галюцинацій присутній завжди. Корисна контрольна точка за участю людини — це момент якраз перед тим, як вихідні дані ШІ стануть публічними або надійдуть до іншого важливого процесу; приклади включають затвердження чернетки перед публікацією, переклад перед випуском або метадані перед індексацією, згідно з рекомендаціями Sanity 2026 року. Шляхом втручання людського контролю саме на цих критичних етапах підприємства запобігають тому, щоб неперевірені згенеровані машиною твердження забруднювали архіви, доступні громадськості, або викликали автоматичні штрафи від пошукових систем за низькоякісний контент.
Що важливо, ефективність цих контрольних точок повністю залежить від справжніх повноважень, якими наділений рецензент-людина. Шлюз перевірки людиною працює найкраще, коли рецензент має чіткі повноваження на доопрацювання або відхилення чернетки; крок затвердження, який не змінює робочий процес у разі виявлення проблем, не є змістовним контролем людини в контурі, як зазначає Sanity у 2026 році. Якщо рецензент виявляє логічні помилки, неперевірені статистичні твердження або тон, який суперечить рекомендаціям бренду, він повинен мати абсолютне право зупинити послідовність публікації та надіслати чернетку на повну перебудову або повністю відкинути її. Формальне схвалення машинного виводу лише для підтримки показників обсягу публікацій зводить нанівець всю мету контрольного шлюзу та наражає підприємство на серйозну репутаційну шкоду.
Щоб ефективно реалізувати це в сучасних робочих процесах створення контенту, команди повинні розписати свої редакційні пайплайни та встановити чіткі функціональні обов’язки для кожної фази виробництва. Наступна розбивка ілюструє, як мають бути структуровані повноваження на різних етапах пайплайну публікацій за підтримки ШІ:
| Етап пайплайну | Дія, ініційована ШІ | Необхідна роль людини | Наслідки збою без HITL |
|---|---|---|---|
| Створення чернетки | Компіляція необробленої статті на основі автоматизованих промптів | Контент-редактор | Публікація фактичних помилок, галюцинацій та запозичених структур |
| Виробництво метаданих | Створення тегів заголовків, мета-описів та схем | SEO-спеціаліст | Каннібалізація ключових слів, оманливі сніпети та помилки інндексації |
| Локалізація | Автоматизований переклад на мови регіональних ринків | Рецензент-носій мови | Культурна нечутливість, порушення нормативних вимог та спотворені повідомлення |
| Фінальний випуск | Автоматизоване відправлення до Системи управління контентом (CMS) | Випусковий редактор | Негайний публічний доступ до тексту, що завдає шкоди бренду або є юридично небезпечним |
Вбудовування цих перевірок у щоденні операції гарантує, що експертиза людини залишається оста тнім арбітром якості, а не другорядною думкою. Організації, які будують системи з обов’язковими, авторитетними циклами відхилення, незмінно перевершують ті, що покладаються на сліпу автоматизацію, захищаючи як довіру своєї аудиторії, так і свою видимість у пошукових системах у довгостроковій перспективі.
Навігація в політиці Google щодо зловживання масовим контентом у 2026 році
Ландшафт пошукових систем у 2026 році вимагає безпрецедентного рівня стратегічної зрілості як від цифрових видавців, так і від творців контенту та корпоративних SEO-команд. Оскільки інструменти штучного інтелекту еволюціонували й тепер можуть генерувати тисячі статей за лічені хвилини, пошукові системи також удосконалили свої алгоритмічні та ручні механізми контролю екосистеми. Щоб зрозуміти сучасні стандарти забезпечення дотримання правил, ми маємо згадати оновлення спам-політики Google у березні 2024 року, яке офіційно запровадило концепцію «зловживання масовим контентом» (scaled content abuse), як описано в офіційних інструкціях, випущених Google Search Central у їхньому оновленні 2024 року «Спам-політика для веб-пошуку Google» (Spam policies for Google web search). Цей поворотний момент змістив парадигму моніторингу з вузького, застарілого фокуса на тому, чи був створений контент автоматично, у бік оцінки намірів, якості виконання та справжньої цінності для користувача.
Ключова відмінність у сучасних критеріях оцінки пошукових систем полягає в тому, що політика щодо масового контенту стосується насамперед мети, а не лише авторства ШІ. Згідно з документацією Google Search Central за 2024 рік, написана людиною сторінка може отримати такий самий суворий штраф, як і невідредагована синтетична стаття, якщо вона масово виробляється головним чином для маніпулювання пошуковими рейтингами, пропонуючи кінцевому користувачеві малу або взагалі нульову оригінальну цінність. Протягом двох років, що передували 2026 року, офіційні рекомендації Google систематично розширювали свою сферу застосування. Вони вийшли за межі ранніх алгоритмічних спроб, які лише позначали написаний машиною текст, перетворившись на всеосяжну систему боротьби зі зловживанням масовим контентом. Ця система охоплює великі партії низькоякісних сторінок незалежно від методу створення: чи то вони повністю згенеровані машиною, чи то є гібридними комбінаціями людини та ШІ, чи навіть поспіхом зібрані командами авторів-людей, які працюють за суворими, незмінними квотами на обсяг.
Оцінюючи масово вироблені цифрові активи, пошукові системи аналізують кілька чітких сигналів, щоб визначити маніпулятивні наміри. Неоригінальність виділяється як основний вектор для застосування штрафних санкцій: якщо тисячі сторінок просто пережовують існуючі записи в базах даних, сканують загальнодоступні гілки форумів або перефразовують конкуруючі статті без додавання первинних досліджень, унікальних даних чи власного тестування, вони викликають негайну алгоритмічну фільтрацію. Крім того, відсутність справжньої цінності для користувача стає кричуще очевидною, коли сторінки структуровані виключно для охоплення низькочастотних варіантів ключових слів без задоволення основних пошукових намірів. Як детально описано в галузевих аналітичних матеріалах, подібних до тих, що висвітлені в прогнозах Search Engine Journal на 2024 рік щодо масштабних алгоритмічних оновлень (див. Prediction: The Next Massive Google Update Is Around The Corner), пошукові системи постійно вдосконалюють свої можливості виявлення контент-ферм, які обходять людський редакційний нагляд. Видавці, які намагаються масштабувати монетизацію за рахунок чистих обсягів, часто виявляють, що їхній трафік випаровується за ніч, якщо їхні робочі процеси суворо не дотримуються принципів «якість понад усе» — ця динаміка детально досліджується в орієнтованих на видавців посібниках про моделі сталого цифрового доходу, таких як Can AI Content Make Money in 2026? A Publisher Guide.
Щоб виживати та процвітати в цьому регуляторному середовищі, сучасні контент-операції повинні відійти від небезпечного мислення про те, що приховування авторства ШІ є ключем до SEO-безпеки. Натомість фокус має повністю зміститися на максимізацію 70-відсоткового редакційного шару, керованого людиною, який гарантує, що кожен опублікований актив привносить у мережу щось нове. Автоматизовані інструменти слід відводити на початкову 10-відсоткову фазу дослідження або фінальну 20-відсоткову фазу редагування, як зазначено в ширших рамках правила 10/20-70. Покладання на ШІ з метою уникнути важкої роботи зі синтезу, експертних інтерв’ю та збору пропрієтарних даних є прямим порушенням духу політики Google щодо масового контенту. Пошукові системи використовують складні моделі машинного навчання для виявлення семантичного повторення, бідних ціннісних пропозицій та передбачуваних синтаксичних патернів на тисячах URL-адрес, що походять з одного домену.
Зрештою, навігація в екосистемі пошукових систем вимагає ставлення до ШІ не як до автоматизованого видавничого верстата, а як до складного помічника, який працює під суворим наглядом людини. Надаючи пріоритет задоволенню користувачів, унікальним інсайтам та суворому дотриманню еталонів якості, описаних в офіційній документації Google, видавці можуть убезпечити себе від раптової алгоритмічної волатильності. Сучасні системи алгоритмічних штрафів не карають технології; вони карають лінь, маніпуляції та навмисне заповнення індексу шумом низької корисності. Забезпечення сталої органічної видимості у 2026 році та надалі вимагає ставлення до кожного окремого шматка контенту — незалежно від того, зачіпає він інструменти ШІ чи ні — як до самостійного активу, який повинен заслужити своє місце в результатах пошуку завдяки незаперечній корисності та суворій редакційній цілісності.
Підвищення редакційних стандартів вище рівня базового вичитування
Коли організації вперше впроваджують великі мовні моделі для масштабування свого цифрового контенту, процес людської перевірки часто гальмується поверхневим підходом до контролю якості. Слабкий робочий процес редагування контенту зі штучним інтелектом зазвичай зводить втручання людини до рудиментарного копірайтингу, де перевантажений член команди просто переглядає згенерований чорновик на наявність друкарських помилок, незв’язних дієприкметникових зворотів та кричущих граматичних помилок. Це базове вичитування розглядає результат роботи штучного інтелекту як майже готовий продукт, що потребує лише легкого лінгвистичного шліфування перед публікацією. Однак покладання на цю стратегію нагляду низького рівня не вирішує фундаментальних структурних, фактичних та стратегічних недоліків, притаманних сирому тексту, згенерованому машиною. Щоб по-справжньому досягти успіху в сучасних пошукових ландшафтах — особливо під час впровадження передових методологій, таких як Automated Content Marketing: Scale Organic Growth in 2026 — видавці повинні перейти від пасивного вичитування до активного багатошарового редакційного управління.
Надійний редакційний нагляд вимагає переведення ролі людини від пасивного коректора граматики до активного архітектора авторитетності, нюансів та стратегічної узгодженості. Комплексний рамковий документ щодо редагування виходить далеко за межі синтаксису, змушуючи рецензентів ретельно перевіряти фактичну точність, глибину предметної області, справжню оригінальність та загальну відповідність ширшим цілям контент-маркетингу. Коли модель штучного інтелекту генерує статтю, вона прогнозує найбільш статистично ймовірну послідовність слів на основі своїх тренувальних даних, що часто призводить до правдоподібних тверджень, застарілої інформації або узагальнених кліше. Суворий протокол рецензування вимагає, щоб експерти-люди активно піддавали сумніву кожне твердження, звіряли статистику з першоджерелами та впроваджували пропрієтарні інсайди, які алгоритм ніколи не зміг би вивести самостійно.
Щоб візуалізувати операційне зрушення, необхідне для високопродуктивних контент-рушіїв, порівняйте традиційне вичитування з глибоким стратегічним редагуванням за критичними вимірами продуктивності:
| Метрика оцінювання | Підхід базового вичитування | Надійний редакційний нагляд |
|---|---|---|
| Граматика та синтаксис | Виправляє друкарські помилки, пунктуацію та пасивний стан. | Уточнює тон голосу, ритм та професійну каденцію. |
| Фактична перевірка | Вважає текст штучного інтелекту в цілому правильним, якщо він легко читається. | Перехресно перевіряє кожну статистику та твердження з перевіреними першоджерелами. |
| Оригінальність та інсайд | Залишає загальний шаблонний текст переважно недоторканим. | Замінює клішовані підсумки пропрієтарними дослідженнями, цитатами експертів та унікальними фреймворками. |
| Стратегічна узгодженість | Ігнорує ширші маркетингові цілі; зосереджується лише на сторінці. | Гарантує, що матеріал відповідає конкретним намірам покупця, етапам воронки та семантичним пошуковим кластерам. |
Вивчення предметних нюансів є одним із найзначніших викликів в управлінні згенерованими штучним інтелектом чорновиками. Мовні моделі чудово справляються зі створенням узагальнених оглядів складних тем, проте вони постійно стикаються з труднощами у роботі з тонкими деталями на рівні практиків, які формують справжній авторитет бренду. Надійний редакційний огляд вимагає від експертів у відповідній галузі активного пошуку спрощень, оманливих узагальнень та пропущених контекстних застережень. Якщо в статті обговорюються передові технічні архітектури або складні регуляторні рамки, базовий коректор, швидше за все, пропустить текст, оскільки речення течуть плавно. Натомість досвідчений галузевий експерт одразу помітить, де штучний інтелект згладив критичні операційні складнощі, замінивши загальні визначення на дієву реальну механіку.
Крім того, справжня оригінальність рідко досягається лише за допомогою базового алгоритму генерації, що вимагає агресивного втручання людини на етапі редагування. Оскільки моделі штучного інтелекту агрегують консенсус публічного вебпростору, їхній стандартний вихідний результат зазвичай повторює існуючу загальноприйняту мудрість, а не пропонує свіжі перспективи. Підвищення редакційних стандартів означає активний аудит чорновика на наявність комодитизованих точок зору та навмисне впровадження унікальних організаційних перспектив, пропрієтарних тематичних досліджень або першочергового досвіду. Це втручання гарантує, що кінцевий опублікований актив підніметься над зростаючою хвилею загальних результатів пошуку, пропонуючи справжню корисність, яка задовольняє як вибагливих читачів, так і сучасні рекомендації щодо якості пошукових систем.
Нарешті, кожен шматок контенту має ретельно перевірятися на предмет його відповідності загальній редакційній стратегії та комерційним цілям. Граматично бездоганна стаття, яка не зачіпає конкретні болі цільової аудиторії або не спрямовує читача природним шляхом до наступного кроку в подорожі покупця, є операційною невдачею незалежно від того, як швидко вона була створена. Надійний нагляд вимагає від редакторів оцінювати, чи ефективно чорновик підтримує кластери тематичної авторитетності, чи відповідає специфічним матрицям пошукового наміру та чи підтримує послідовне повідомлення бренду. Подолавши етап базового вичитування та прийнявши цю всебічну редакційну суворість, контент-команди зможуть успішно використовувати ефективність інструментів генерації, ніколи не йдучи на компроміс щодо якості, достовірності та стратегічного впливу свого опублікованого цифрового сліду.
Еволюція управління контентом: перехід до нагляду, орієнтованого на робочі процеси
Протягом останніх одного-двох років ландшафт створення цифрового контенту зазнав глибокої трансформації, відійшовши від хаотичних експериментів до дисциплінованих операційних структур. Коли інструменти генеративного штучного інтелекту вперше наводнили масовий ринок, організації застосовували надзвичайно недбалий підхід до їх впровадження. Контент-команди створювали величезні обсяги тексту, зображень і коду з мінімальним наглядом, часто покладаючись на неформальний фінальний погляд втомленого редактора перед тим, як випустити матеріал у світ. Цей хаотичний метод призвів до масового погіршення якості, фактичних неточностей та помітної ерозії голосу бренду в провідних цифрових виданнях. Оскільки алгоритми пошукових систем ставали все більш досконалими у виявленні низькоякісного синтетичного тексту, а користувачі відчували втому від роботоподібних формулювань, цифрові стратеги зрозуміли, що спеціальне редагування більше не є життєздатним для сталого зростання.
Для боротьби з цими вразливими місцями сучасні видавничі операції систематично переглянули свою внутрішню політику, перейшовши до структурованих проектів, орієнтованих на робочі процеси. Замість того щоб розглядати втручання людини як простий другорядний аспект або швидку перевірку на наявність помилок наприкінці конвеєра, організації тепер інтегрують чіткі контрольні точки протягом усього життєвого циклу виробництва. Згідно з фреймворками, викладеними Sanity у їхньому аналізі систем із залученням людини в контур за 2026 рік, надійне управління контентом вимагає визначення обов’язкових етапів затвердження, виправлення або відхилення до того, як будь-який шматок автоматизованого виводу отримає дозвіл на перехід до наступної виробничої стадії або публікацію в реальному середовищі. Цей перехід відображає суворі протоколи забезпечення якості, які зустрічаються в традиційній розробці програмного забезпечення та виробництві, гарантуючи, що штучний інтелект діє як невтомний помічник зі створення чорнеток, а не як неконтрольований видавець.
Впровадження цих чітких контрольних точок перетворює хаотичний письмовий стіл на впорядковану конвеєрну лінію, де ролі та обов’язки чітко розмежовані. У типовому сучасному робочому процесі процес розбивається на окремі операційні фази, які запобігають потраплянню неперевірених матеріалів крізь пальці. Для організацій, які прагнуть ефективно масштабувати ці структуровані конвеєри, впровадження сучасної цифрової інфраструктури має вирішальне значення, тому багато видавничих команд покладаються на спеціалізовані платформи, подібні до тих, що детально описані в статті Top Content Creation Platforms to Scale Your Workflow in 2026, для керування багаторівневими дозволами та автоматизованою маршрутизацією. Без таких систематичних інструментів підтримка детального контролю над сотнями щоденних активів за підтримки штучного інтелекту стає логістично неможливою як для редакційних директорів, так і для офіцерів з комплаєнсу.
Механіка нагляду, орієнтованого на робочий процес, значною мірою спирається на умовну маршрутизацію на основі оцінки ризиків та складності контенту. Наприклад, інформаційні статті з низьким рівнем ризику можуть проходити через єдиний фільтр автоматизованої валідації з подальшим швидким стилістичним оглядом, тоді як критично важливий фінансовий, юридичний чи медичний контент повинен викликати обов’язкові вторинні та третинні перевірки людиною. За цих розширених фреймворків модель штучного інтелекту генерує початкову чорнетку, але система автоматично блокує чергу публікацій доти, доки кваліфікований експерт у відповідній галузі не перевірить певні теги метаданих. Якщо рецензент-людина виявляє фактичні галюцинації, упереджене подання або тональні невідповідності, він може відхилити чорнетку назад до певного вузла виправлення замість того, щоб вручну виправляти помилки з нуля, зберігаючи таким чином підзвітність і вдосконалюючи базові промпти для майбутніх циклів.
Крім того, ця еволюція в управлінні вирішує регуляторний тиск та проблеми безпеки бренду, які значно посилилися за останні двадцять чотири місяці. Регуляторні органи та галузеві спостерігачі все частіше вимагають прозорості щодо того, як створюється та перевіряється синтетичний медіаконтент до його публічного споживання. Інституціоналізуючи суворі наглядові конвеєри, компанії можуть створювати незмінні журнали аудиту, які документують кожне втручання людини, виправлення та остаточне затвердження. Цей рівень простежуваності не лише захищає бренд від репутаційної шкоди та алгоритмічних штрафів, а й дає внутрішнім командам можливість вимірювати справжнє зростання ефективності від інвестицій у генеративні технології. Зрештою, перехід від неформальних поглядів до структурованого управління робочими процесами знаменує дорослішання операцій із контентом на базі штучного інтелекту, доводячи, що стале масштабування вимагає абсолютної операційної дисципліни.